
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | 4 | 5 | ||
| 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| 13 | 14 | 15 | 16 | 17 | 18 | 19 |
| 20 | 21 | 22 | 23 | 24 | 25 | 26 |
| 27 | 28 | 29 | 30 |
- 프랍데스크
- DMA trading
- high frequency trading
- dma거래
- low latency
- 고빈도매매
- rms개발
- fep개발
- mmlp
- DMA개발
- 저지연시스템
- 시스템 트레이딩
- krx nxt
- Arbitrage Trading
- low latency trading
- dma fep
- korea inbound
- 자기매매
- 주문fep
- ultra low latency
- dma development
- hft개발
- dma hft
- KRX HFT
- system trading
- HFT system
- 자동매매
- korea market
- Korea krx
- algo trading
- Today
- Total
Fontes Fintech
저지연 트레이딩 시스템에서 CPU Affinity와 Core Pinning이 중요한 이유 | Trading Engineering — Deep Dive #3 본문
저지연 트레이딩 시스템에서 CPU Affinity와 Core Pinning이 중요한 이유 | Trading Engineering — Deep Dive #3
폰테스 핀테크 :: 금융거래의 안전한 미래 2026. 9. 19. 00:40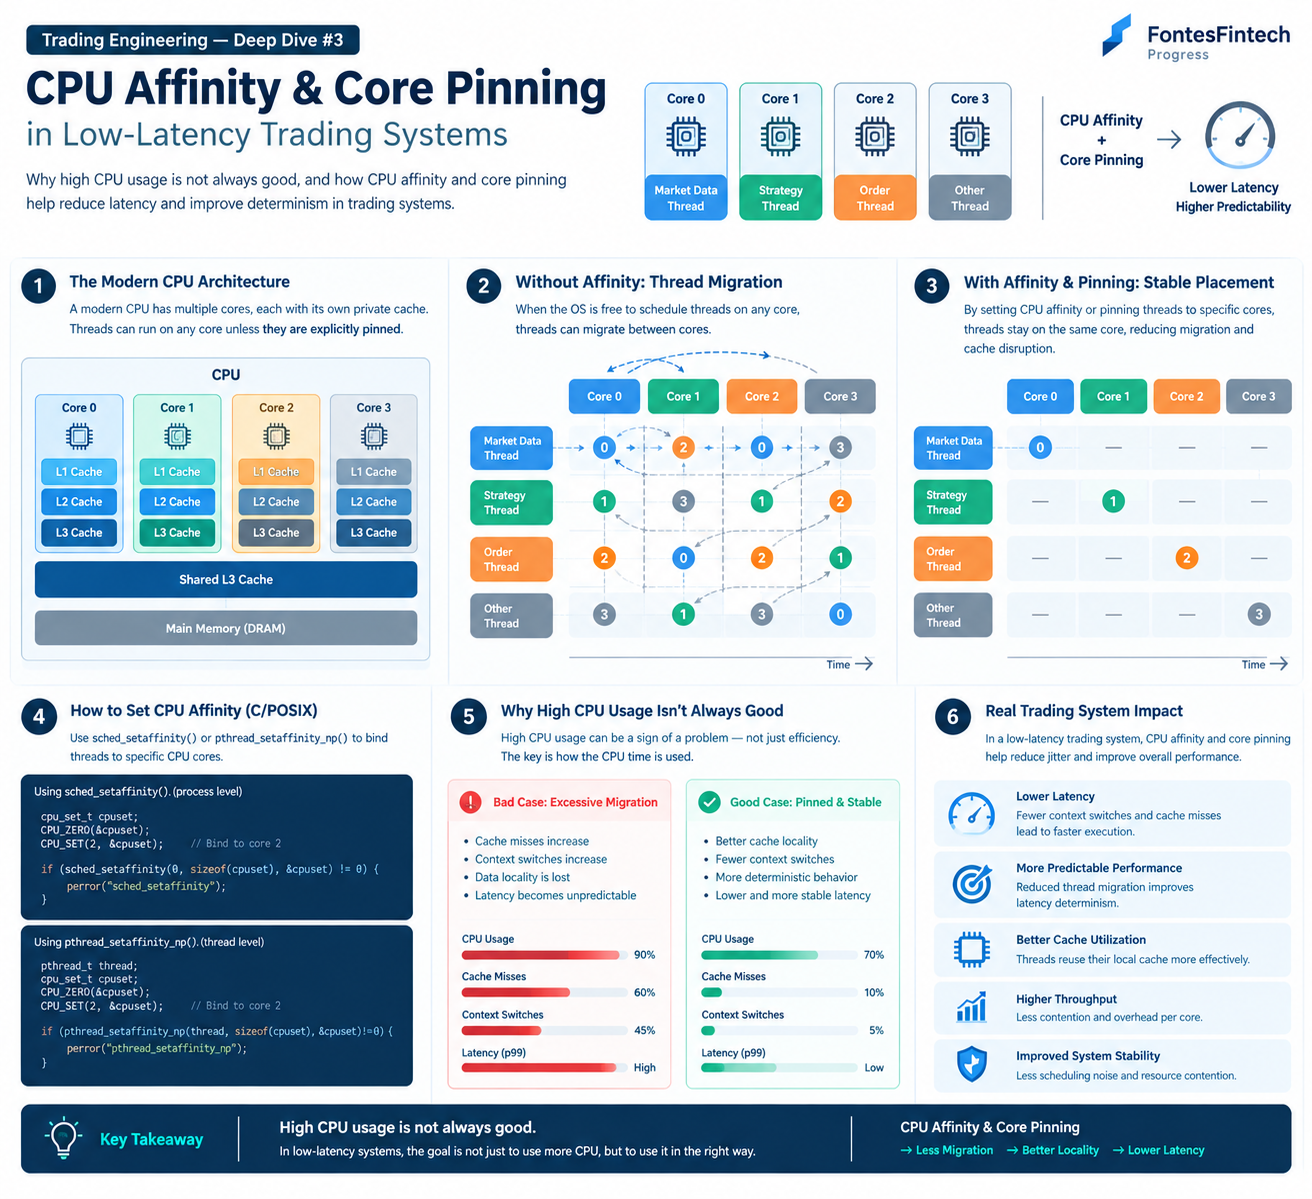
저지연 트레이딩 시스템에서 CPU Affinity와 Core Pinning이 중요한 이유
Trading Engineering — Deep Dive #3
저지연 Trading System에서 CPU 성능을 이야기할 때 흔히 다음과 같은 질문을 합니다.
"CPU 사용률을 최대한 높이면 성능도 좋아지는 것 아닌가?"
반드시 그렇지는 않습니다.
저지연 시스템에서는 CPU를 얼마나 많이 사용하는가뿐만 아니라,
어떤 Thread가 어떤 Core에서 실행되는가
도 중요합니다.
Operating System의 Scheduler는 일반적으로 시스템 전체의 CPU 자원을 효율적으로 사용하기 위해 Thread를 여러 CPU Core에 분산시킵니다.
하지만 매우 짧은 시간 안에 반복적으로 데이터를 처리해야 하는 Trading System에서는 Thread가 Core 사이를 이동하는 Thread Migration이 불필요한 Cache 손실과 실행 지연을 만들 수 있습니다.
이때 활용할 수 있는 대표적인 방법이
CPU Affinity와 Core Pinning입니다.
1. CPU Affinity란?
CPU Affinity는 특정 Process 또는 Thread가 실행될 수 있는 CPU Core의 범위를 지정하는 기능입니다.
예를 들어 시스템에 8개의 CPU Core가 있다고 가정해보겠습니다.
CPU
 ├── Core 0
 ├── Core 1
 ├── Core 2
 ├── Core 3
 ├── Core 4
 ├── Core 5
 ├── Core 6
 └── Core 7
일반적인 Scheduler 환경에서는 특정 Thread가 상황에 따라 여러 Core에서 실행될 수 있습니다.
반면 CPU Affinity를 설정하면 다음과 같이 특정 Core에 실행 범위를 제한할 수 있습니다.
Market Data Thread → Core 2
Strategy Thread    → Core 3
Order Thread       → Core 4
여기서 더 좁게 하나의 Core에 고정하는 것을 흔히 Core Pinning이라고 표현합니다.
즉,
CPU Affinity는 Thread가 실행될 수 있는 CPU의 범위를 제한하고, Core Pinning은 특정 Core에 Thread를 고정하는 방식으로 이해할 수 있습니다.
실제 시스템에서는 두 용어가 혼용되기도 합니다.
2. 왜 Thread Migration이 문제가 되는가?
Operating System Scheduler가 Thread를 다른 Core로 이동시키는 것을 Thread Migration이라고 합니다.
일반적인 서버 환경에서는 이런 이동이 시스템 전체의 CPU 자원을 효율적으로 사용하는 데 도움이 될 수 있습니다.
하지만 저지연 시스템에서는 다른 문제가 발생할 수 있습니다.
예를 들어 Strategy Thread가 처음 Core 2에서 실행되었다고 생각해보겠습니다.
그 과정에서 다음과 같은 데이터가 Core 2의 Cache에 올라갑니다.
Market Data
Strategy State
Order Book
Position
Risk State
그런데 Scheduler에 의해 Thread가 Core 5로 이동하면 어떻게 될까요?
Core 5의 Cache에는 이전에 사용하던 데이터가 없을 수 있습니다.
결과적으로 다시 Cache를 채우는 과정이 필요할 수 있습니다.
즉,
Thread Migration → Cache Locality 저하 → 추가 Memory Access → Latency 증가 가능성
이라는 관계가 만들어질 수 있습니다.
3. CPU Cache와 Thread Migration
앞의 Deep Dive #1에서 CPU Cache를 살펴봤습니다.
CPU Cache는 단순히 빠른 메모리가 아닙니다.
자주 사용하는 데이터를 가까운 곳에 유지함으로써 Memory Access 비용을 줄이는 역할을 합니다.
따라서 Thread와 데이터가 일정한 Core에 지속적으로 머무르는 것은 Cache Locality 측면에서 유리할 수 있습니다.
개념적으로 보면:
Migration이 많은 경우
Thread
  ↓
Core 0
  ↓
Core 2
  ↓
Core 5
  ↓
Core 1
Thread가 이동하면서 각 Core의 Cache 상태도 달라질 수 있습니다.
반면:
Core Pinning
Strategy Thread
      ↓
    Core 3
      ↓
  Local Cache
Thread가 동일한 Core에서 계속 실행될 가능성이 높아지고, 해당 Core의 Cache에 있는 데이터를 재사용하기 쉬워집니다.
물론 이것이 항상 Cache Miss를 없앤다는 의미는 아닙니다.
Memory Access Pattern, 다른 Thread의 접근, Cache Capacity 등 다양한 요소가 영향을 줍니다.
핵심은 불필요한 Thread Migration을 줄여 Cache Locality와 실행의 일관성을 높이는 것입니다.
4. CPU Affinity를 C에서 설정하기
Linux 환경에서는 sched_setaffinity() 또는 pthread_setaffinity_np() 등을 사용하여 CPU Affinity를 설정할 수 있습니다.
Process 단위로 설정하는 간단한 예는 다음과 같습니다.
#define _GNU_SOURCE

#include <sched.h>
#include <stdio.h>
#include <unistd.h>

int main(void)
{
    cpu_set_t cpuset;

    CPU_ZERO(&cpuset);
    CPU_SET(2, &cpuset);

    if (sched_setaffinity(0,
                          sizeof(cpu_set_t),
                          &cpuset) != 0) {
        perror("sched_setaffinity");
        return 1;
    }

    while (1) {
        /* latency-sensitive work */
    }

    return 0;
}
여기서는 현재 Process가 실행될 수 있는 CPU를 Core 2로 제한합니다.
Thread 단위로 설정하는 경우에는 pthread_setaffinity_np()를 사용할 수 있습니다.
#define _GNU_SOURCE

#include <pthread.h>
#include <sched.h>
#include <stdio.h>

void *strategy_thread(void *arg)
{
    cpu_set_t cpuset;

    CPU_ZERO(&cpuset);
    CPU_SET(3, &cpuset);

    if (pthread_setaffinity_np(
            pthread_self(),
            sizeof(cpu_set_t),
            &cpuset) != 0) {
        perror("pthread_setaffinity_np");
        return NULL;
    }

    while (1) {
        /* strategy processing */
    }

    return NULL;
}
이 경우 Strategy Thread를 Core 3에 고정하는 것을 의도한 구조입니다.
5. Core Pinning을 적용한다고 무조건 빨라지는가?
그렇지는 않습니다.
이 부분이 매우 중요합니다.
Core Pinning은 성능을 자동으로 향상시키는 최적화 옵션이 아닙니다.
오히려 잘못 사용하면 전체 시스템 성능을 떨어뜨릴 수 있습니다.
예를 들어 8 Core 시스템에서 중요한 Thread를 모두 Core 2에 몰아넣으면:
Core 0   Idle
Core 1   Idle
Core 2   ████████████████████
Core 3   Idle
Core 4   Idle
Core 5   Idle
Core 6   Idle
Core 7   Idle
Core 2에 CPU contention이 발생할 수 있습니다.
따라서 Core Pinning에서는 어떤 Thread를 어떤 Core에 배치할 것인가가 중요합니다.
6. Trading System에서는 어떻게 배치할 것인가?
예를 들어 다음과 같은 Trading System을 생각해보겠습니다.
Market Data
     ↓
Strategy
     ↓
Risk Check
     ↓
Order Manager
     ↓
DMA / FEP
     ↓
Exchange
각 기능을 별도의 Thread로 구성한다면 CPU Core 배치를 고려할 수 있습니다.
예를 들어:
Core 0 → OS / General Tasks
Core 1 → Market Data
Core 2 → Strategy
Core 3 → Risk / Order
Core 4 → DMA / FEP
Core 5 → Logging / Monitoring
물론 이것이 정답은 아닙니다.
실제 배치는 다음을 함께 고려해야 합니다.
- CPU Core 수
- SMT / Hyper-Threading
- Thread 수
- Thread별 CPU 사용량
- Market Data 처리량
- Order 처리량
- IPC 구조
- Shared Memory
- NUMA topology
- NIC interrupt
- OS Scheduler
- Logging 방식
- 실제 Latency 측정 결과
즉,
Core Pinning은 Architecture와 함께 설계해야 합니다.
7. CPU 사용률이 높다고 좋은 것은 아니다
저지연 시스템에서 CPU 사용률을 단순히 100%에 가깝게 만드는 것이 목표가 되어서는 안 됩니다.
예를 들어:
CPU Usage = 95%
라는 숫자만으로는 시스템이 좋은 상태인지 판단할 수 없습니다.
95%의 CPU가
- 실제 주문 처리에 사용되고 있는지,
- Cache Miss 때문에 반복적으로 Memory를 기다리고 있는지,
- Thread Migration이 발생하고 있는지,
- Lock을 기다리고 있는지,
- 다른 Process와 CPU를 경쟁하고 있는지
알 수 없기 때문입니다.
따라서 CPU 사용률보다는 CPU time이 어디에 사용되고 있는가가 더 중요할 수 있습니다.
저지연 시스템에서는 다음 지표를 함께 살펴볼 필요가 있습니다.
- CPU Utilization
- Context Switch
- Thread Migration
- Cache Miss
- CPU Cycles
- IPC
- Lock Contention
- Tail Latency
- Throughput
8. Core Pinning과 Cache Locality
Core Pinning의 중요한 장점 중 하나는 Cache Locality를 유지하기 쉬워진다는 것입니다.
예를 들어 Strategy Thread가 반복적으로 다음 데이터를 사용한다고 생각해보겠습니다.
Order Book
Strategy State
Position
Risk State
Configuration
하나의 Core에서 지속적으로 실행된다면 이전 실행에서 만들어진 Cache 상태를 다시 활용할 가능성이 있습니다.
반대로 Thread가 여러 Core를 이동하면 새로운 Core의 Cache를 다시 채워야 하는 상황이 발생할 수 있습니다.
따라서:
Core Affinity
→ Thread Migration 감소
→ Cache Locality 개선 가능
→ Memory Access 비용 감소 가능
→ Latency Variability 감소 가능
이라는 구조를 생각할 수 있습니다.
여기서 중요한 표현은 "가능"입니다.
실제 성능 향상은 반드시 Benchmark를 통해 확인해야 합니다.
9. CPU Affinity와 Lock Contention
앞선 Deep Dive #2에서는 False Sharing을 살펴봤습니다.
CPU Affinity는 False Sharing과도 연결될 수 있습니다.
예를 들어:
Thread A
   ↓
Core 2
   ↓
Shared Data

Thread B
   ↓
Core 3
   ↓
Shared Data
두 Thread가 같은 데이터를 반복적으로 접근하면 Cache Coherency Traffic이 발생할 수 있습니다.
여기에 Lock까지 추가되면:
Thread
  ↓
Lock
  ↓
Shared Data
  ↓
Cache Line
  ↓
Another Core
처럼 여러 종류의 비용이 동시에 나타날 수 있습니다.
따라서 저지연 시스템에서는
CPU Affinity + Data Ownership + Cache Layout + Synchronization
을 함께 고려해야 합니다.
특정 최적화 하나만 적용해서 전체 성능 문제가 해결되는 경우는 많지 않습니다.
10. CPU Affinity와 NUMA
CPU Affinity를 이해하면 자연스럽게 NUMA라는 개념으로 연결됩니다.
대규모 서버에서는 CPU Core와 Memory가 하나의 균일한 구조가 아니라 여러 NUMA Node로 구성될 수 있습니다.
개념적으로:
NUMA Node 0
CPU 0~7
   │
Memory 0

NUMA Node 1
CPU 8~15
   │
Memory 1
이때 Thread가 Node 0의 CPU에서 실행되면서 Node 1의 Memory를 반복적으로 접근한다면 Local Memory보다 더 높은 접근 비용이 발생할 수 있습니다.
따라서 고성능 시스템에서는:
CPU Core
뿐만 아니라
CPU Core ↔ Memory ↔ NIC
의 위치 관계까지 고려해야 합니다.
이것이 다음 Deep Dive에서 NUMA를 다루는 이유입니다.
11. CPU Affinity를 적용할 때 주의할 점
1. 모든 Thread를 Pinning하지 않는다
OS가 Scheduler를 통해 효율적으로 관리하는 것이 더 나은 Thread도 많습니다.
2. CPU Core를 독점할 수 있는지 확인한다
다른 Process나 중요한 OS 작업과 Core를 공유하면 예상과 다른 결과가 나올 수 있습니다.
3. SMT를 고려한다
Hyper-Threading / SMT 환경에서는 논리 CPU가 물리 Core를 어떻게 공유하는지 확인해야 합니다.
4. IRQ와 NIC를 고려한다
고속 Network Interface를 사용하는 시스템에서는 NIC Interrupt가 어느 CPU에서 처리되는지도 중요할 수 있습니다.
5. NUMA를 고려한다
대규모 서버에서는 CPU와 Memory의 NUMA 위치까지 함께 봐야 합니다.
6. 반드시 측정한다
Pinning 전후의 결과를 비교해야 합니다.
12. Measure Before and After
CPU Affinity 역시 측정 기반 최적화가 핵심입니다.
다음과 같은 실험을 생각할 수 있습니다.
Before
OS Scheduler가 Thread를 자유롭게 배치
측정:
- End-to-End Latency
- P99
- P99.9
- Thread Migration
- Context Switch
- Cache Miss
- CPU Utilization
After
Latency-sensitive Thread에 CPU Affinity 적용
다시 동일한 환경에서 측정합니다.
그리고 다음을 비교합니다.
Average Latency
P99 Latency
P99.9 Latency
Thread Migration
Context Switch
Cache Miss
Throughput
특히 Trading System에서는 Average보다 Tail Latency가 어떻게 변했는지가 중요할 수 있습니다.
13. Low-Latency Trading System에서의 적용
예를 들어 DMA Trading System을 다음과 같이 구성한다고 생각해보겠습니다.
Market Data
      ↓
Market Data Thread
      ↓
   Strategy
      ↓
Pre-Trade Risk
      ↓
Order Manager
      ↓
   DMA / FEP
      ↓
   Network
      ↓
 Exchange
여기서 Latency-sensitive Thread를 적절한 Core에 배치하고,
각 Thread의 Data Ownership을 명확히 하며,
Shared Memory / Ring Buffer를 통해 Thread 간 데이터 전달을 단순화하고,
불필요한 Lock과 Memory Copy를 줄이면,
전체 Critical Path의 실행 특성을 보다 예측 가능하게 만들 수 있습니다.
즉 CPU Affinity는 단독 기술이 아니라 우리가 앞서 살펴본 여러 최적화 기법과 함께 사용되는 시스템 설계 요소입니다.
14. FontesFintech의 접근
저지연 Trading System에서 CPU를 단순히 "많이 사용하는 자원"으로 보는 것과,
"어디에 어떻게 배치해서 사용할 것인가"
를 고민하는 것은 다릅니다.
FontesFintech는 다음 요소를 함께 고려합니다.
- CPU Affinity
- Core Pinning
- Thread-to-Core Mapping
- Cache Locality
- Data Ownership
- Shared Memory
- Ring Buffer
- Lock Contention
- False Sharing
- NUMA Locality
- NIC / IRQ Placement
- End-to-End Latency
- Tail Latency
결국 중요한 것은 CPU 사용률 자체가 아닙니다.
Latency-sensitive 작업에 CPU 자원을 어떻게 배치하고, 데이터와 CPU의 거리를 어떻게 줄이며, 불필요한 Thread Migration과 공유 상태를 어떻게 줄이는가입니다.
Conclusion
CPU Affinity와 Core Pinning은 단순히 Thread를 특정 CPU에 고정하는 기능이 아닙니다.
저지연 시스템에서는 다음과 같은 관계로 이해할 수 있습니다.
Thread Placement
→ Cache Locality
→ Data Access
→ Execution Predictability
→ Latency
특히 Trading System에서는 몇 마이크로초의 평균 성능뿐만 아니라 Latency의 변동성과 Tail Latency까지 고려해야 합니다.
따라서 Core Pinning 역시 "무조건 적용하면 빠르다"가 아니라,
측정하고, 필요한 Thread를 식별하고, 적절한 Core에 배치한 후 다시 측정하는 과정
이 중요합니다.
저지연 시스템에서는 CPU를 얼마나 사용하는가보다, CPU를 어떻게 배치하고 사용하는가가 중요합니다.
다음 편에서는 CPU Core에서 한 단계 더 나아가,
NUMA와 Memory Locality가 저지연 Trading System의 성능에 어떤 영향을 미치는가
를 살펴보겠습니다.


