저지연 트레이딩 시스템에서 Interrupt, Polling과 Network Latency가 중요한 이유 | Trading Engineering — Deep Dive #6
저지연 트레이딩 시스템에서 Interrupt, Polling과 Network Latency가 중요한 이유
Trading Engineering — Deep Dive #6
저지연 트레이딩 시스템에서 네트워크 패킷을 받는 것은 시작에 불과합니다.
시장 데이터 패킷이나 주문 응답은 실제 애플리케이션이 처리하기까지 여러 계층을 거쳐야 합니다.
단순화하면 다음과 같습니다.
NIC
 ↓
Interrupt / Polling
 ↓
Kernel
 ↓
Network Stack
 ↓
Socket
 ↓
Application
각 단계에서 latency가 발생할 수 있습니다.
그리고 들어오는 패킷을 어떻게 감지하고 처리하는가에 따라 latency와 CPU 사용량이 크게 달라질 수 있습니다.
따라서 저지연 트레이딩 시스템을 설계할 때는 Interrupt, Polling 그리고 NAPI를 이해하는 것이 중요합니다.
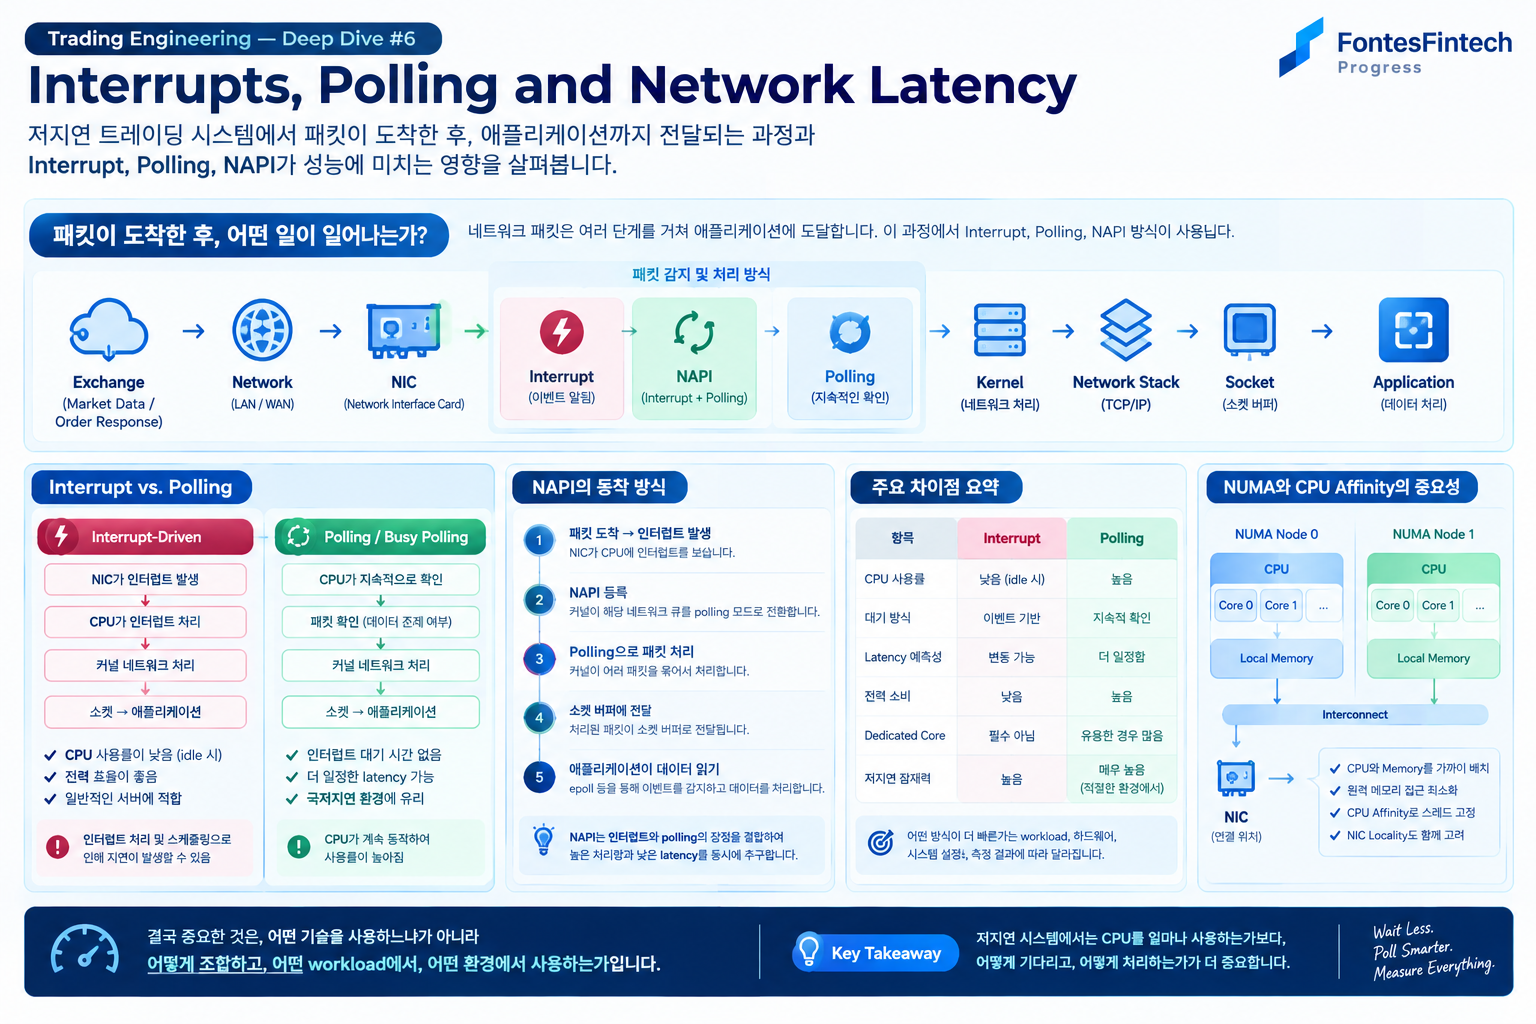
1. 네트워크 패킷이 도착하면 어떤 일이 일어나는가?
간단한 예를 들어보겠습니다.
거래소에서 시장 데이터 패킷이 서버에 도착합니다.
Exchange
   ↓
Network
   ↓
NIC
   ↓
Linux Kernel
   ↓
Socket Buffer
   ↓
Trading Application
애플리케이션이 패킷을 즉시 받는 것은 아닙니다.
실제 recv()나 read()가 데이터를 가져오기까지 하드웨어와 커널을 포함한 여러 단계가 존재합니다.
이 과정을 이해하면 서로 다른 네트워크 아키텍처가 왜 서로 다른 latency 특성을 갖는지도 이해할 수 있습니다.
2. 전통적인 Interrupt 기반 네트워킹
전통적인 방식 중 하나는 Interrupt-driven networking입니다.
개념적으로 보면 다음과 같습니다.
Packet Arrives
      ↓
NIC
      ↓
Interrupt
      ↓
CPU
      ↓
Kernel Network Processing
      ↓
Socket
      ↓
Application
NIC가 패킷을 수신하면 Interrupt를 통해 CPU에 이벤트를 알릴 수 있습니다.
그러면 CPU가 해당 네트워크 이벤트를 처리하기 시작합니다.
이 방식의 중요한 장점은 다음과 같습니다.
패킷이 들어오지 않을 때 CPU가 NIC를 계속 확인할 필요가 없습니다.
따라서 네트워크가 idle인 동안 CPU 자원을 다른 작업에 사용할 수 있습니다.
일반적인 서버 환경에서는 매우 유용한 구조입니다.
하지만 Interrupt에도 비용이 있습니다.
3. Interrupt가 latency를 증가시킬 수 있는 이유
Interrupt는 단순히 다음과 같은 구조가 아닙니다.
Packet → Application
하드웨어 이벤트가 발생한 후 애플리케이션이 데이터를 처리하기까지 여러 단계가 존재합니다.
단순화하면:
NIC
 ↓
Interrupt
 ↓
Kernel
 ↓
Network Stack
 ↓
Socket
 ↓
Application
CPU가 하드웨어 이벤트를 처리하고 커널의 네트워크 처리 경로를 거친 뒤 애플리케이션까지 도달해야 합니다.
또한 scheduling이나 batching 등의 영향도 받을 수 있습니다.
일반적인 서버 애플리케이션에서는 이러한 비용이 충분히 감당할 수 있는 수준일 수 있습니다.
하지만 극도로 latency에 민감한 시스템에서는 이러한 작은 지연과 변동성도 중요해질 수 있습니다.
그래서 다음과 같은 질문이 생깁니다.
정말 매번 Interrupt를 기다려야 할까?
4. Polling
Polling은 다른 접근 방법입니다.
NIC가 CPU에 알려주기를 기다리는 대신 CPU가 지속적으로 데이터가 있는지 확인합니다.
개념적으로는 다음과 같습니다.
while (running)
{
    check_for_packet();

    if (packet_available)
        process_packet();
}
CPU가 계속 실행되고 있기 때문에 다음과 같은 구조가 가능합니다.
No Waiting
   ↓
Check Immediately
   ↓
Process Packet
장점은 분명합니다.
Interrupt가 CPU를 깨우는 과정을 기다리지 않아도 됩니다.
하지만 당연히 비용도 있습니다.
패킷이 없어도 CPU Core가 계속 동작합니다.
5. Interrupt vs. Polling
간단하게 비교하면 다음과 같습니다.
Interrupt-DrivenPolling
| CPU 사용량 | Idle 시 낮음 | 높음 |
| 대기 방식 | Event 기반 | 지속적인 확인 |
| 처리 경로 | Event-driven | Continuous |
| Latency 예측성 | 변동 가능 | 더 일정하게 만들 수 있음 |
| 전력 소비 | 일반적으로 낮음 | 일반적으로 높음 |
| Dedicated Core | 필수 아님 | 유용한 경우가 많음 |
| Low-Latency 잠재력 | 높음 | 적절한 환경에서 매우 높음 |
어느 하나가 항상 더 빠른 것은 아닙니다.
중요한 질문은 이것입니다.
어떤 workload인가?
6. Linux NAPI
Linux networking에는 NAPI(New API)라는 중요한 메커니즘이 있습니다.
NAPI는 Interrupt와 Polling의 장점을 결합하는 방식으로 이해할 수 있습니다.
단순화하면 다음과 같습니다.
             Packet Arrives
                   ↓
                  NIC
                   ↓
              Interrupt
                   ↓
             NAPI Polling
                   ↓
            Network Stack
                   ↓
                Socket
                   ↓
             Application
기본적인 아이디어는 다음과 같습니다.
처음에는 Interrupt가 패킷 도착을 알립니다.
그 이후 커널은 일정 조건에서 polling 방식으로 패킷을 처리할 수 있습니다.
이렇게 하면 traffic이 많은 상황에서 모든 패킷마다 별도의 Interrupt를 처리하는 부담을 줄일 수 있습니다.
핵심은 다음과 같습니다.
Interrupt는 activity를 감지하고, Polling은 traffic이 많은 상황에서 패킷을 효율적으로 처리하는 데 활용할 수 있습니다.
이러한 Hybrid 방식은 현대 Linux networking의 중요한 개념 중 하나입니다.
7. Packet Rate에 따라 적절한 방식이 달라진다
두 가지 상황을 생각해보겠습니다.
Low Traffic
Packet
   ↓
          idle
   ↓
Packet
   ↓
          idle
   ↓
Packet
패킷 사이에 긴 idle 시간이 존재합니다.
이 상황에서 계속 polling하면 패킷이 없는 동안에도 CPU를 사용하게 됩니다.
따라서 Interrupt 기반 처리가 효율적일 수 있습니다.
High Traffic
이번에는 다음과 같은 상황을 생각해보겠습니다.
Packet Packet Packet Packet Packet Packet
   ↓
   ↓
   ↓
   ↓
   ↓
   ↓
Continuous Traffic
패킷이 매우 빠르게 계속 들어옵니다.
이때 모든 패킷마다 Interrupt를 발생시키고 처리한다면 Interrupt 처리 자체의 overhead가 커질 수 있습니다.
따라서 Polling과 batching이 보다 효율적인 상황이 발생할 수 있습니다.
이것이 현대적인 네트워크 처리에서 Interrupt와 Polling을 결합한 구조가 사용되는 이유 중 하나입니다.
8. Interrupt Moderation과 Batching
Network Hardware 역시 Interrupt 발생 횟수를 줄이기 위한 여러 기능을 제공합니다.
단순화하면:
Packet 1 → Interrupt
Packet 2 → Interrupt
Packet 3 → Interrupt
Packet 4 → Interrupt
대신 여러 패킷을 묶어서 처리할 수 있습니다.
Packet 1
Packet 2
Packet 3
Packet 4
     ↓
   Batch
     ↓
 Processing
이렇게 하면 패킷 하나당 발생하는 처리 overhead를 줄여 throughput을 높이는 데 도움이 될 수 있습니다.
하지만 trade-off가 있습니다.
여러 패킷을 모으기 위해 기다리게 되면 첫 번째 패킷이 추가적인 지연을 경험할 수 있습니다.
따라서:
Batching은 효율성을 높일 수 있지만, latency를 증가시킬 수도 있습니다.
High-throughput 시스템에서는 이러한 trade-off가 유용할 수 있습니다.
반면 ultra-low-latency 시스템에서는 그 균형을 실제로 측정해야 합니다.
9. Latency vs. CPU Efficiency
결국 중요한 것은 다음과 같은 trade-off입니다.
                    CPU Efficiency
                         ↑
                         │
Interrupt-driven        │
                         │
                         │
                         │
                         │
                         └────────────────→ Latency Optimization

                              Polling
물론 실제 시스템에서는 이렇게 단순한 관계가 아닙니다.
결과는 다음과 같은 요소에 따라 달라집니다.
- NIC
- Network Driver
- Kernel Version
- CPU Architecture
- Packet Rate
- Packet Size
- Number of Queues
- CPU Core Assignment
- NUMA Topology
- Application Architecture
따라서 모든 시스템에 적용되는 "가장 빠른 네트워크 설정"은 존재하지 않습니다.
10. epoll은 또 다른 계층이다
앞선 Deep Dive #5에서는 epoll을 살펴봤습니다.
여기서 중요한 것은 NIC에서 패킷을 처리하는 과정과 애플리케이션이 Event를 감지하는 과정은 서로 다른 계층이라는 점입니다.
단순화하면:
NIC
 ↓
Driver / Kernel
 ↓
Socket Buffer
 ↓
epoll
 ↓
Application
epoll_wait()는 file descriptor가 I/O 가능한 상태가 되기를 기다립니다.
이벤트가 없다면 호출한 thread는 block될 수 있습니다.
이벤트가 발생하면 epoll_wait()가 반환되고 애플리케이션이 해당 file descriptor를 처리합니다.
따라서 epoll은 다음과 같은 polling loop와는 본질적으로 다릅니다.
while (1)
{
    check();
}
후자는 애플리케이션이 계속해서 상태를 확인하는 Busy Polling 방식입니다.
11. epoll과 Busy Polling은 정확히 같은 개념이 아니다
이 부분은 상당히 중요합니다.
Polling은 여러 계층에서 발생할 수 있습니다.
Application-Level Polling
Application
    ↓
read()
    ↓
check
    ↓
check
    ↓
check
Socket / Kernel-Level Busy Polling
Kernel이 polling을 사용하여 패킷 도착 후 socket 처리까지의 시간을 줄이는 방식이 있을 수 있습니다.
NIC / Driver Polling
Network Driver가 NIC의 Receive Queue를 polling할 수도 있습니다.
User-Space Networking
더 나아가 packet processing의 상당 부분을 User Space에서 처리하는 구조도 있습니다.
대표적인 예로:
- DPDK
- User-space networking framework
- Kernel-bypass networking
등을 생각할 수 있습니다.
이러한 방식은 단순히 epoll_wait()를 Busy Loop로 바꾸는 것보다 훨씬 큰 아키텍처 변화입니다.
12. CPU Affinity가 중요해진다
Polling을 사용하면 또 하나의 문제가 생깁니다.
어떤 CPU가 Polling을 수행하는가?
예를 들어:
NIC
 ↓
Polling Thread
 ↓
Strategy
 ↓
Risk
 ↓
Order
Polling Thread가 여러 CPU Core 사이를 이동한다면 Cache Locality가 떨어질 수 있습니다.
이 부분은 Deep Dive #3에서 다룬 CPU Affinity와 Core Pinning으로 연결됩니다.
Latency-sensitive system에서는 특정 processing path에 CPU Core를 dedicated하게 할 수도 있습니다.
예를 들어:
Core 0
Market Data Polling

Core 1
Order Book

Core 2
Strategy

Core 3
Risk / Order Management
물론 실제 설계에서는 workload와 hardware topology를 함께 고려해야 합니다.
13. NUMA도 다시 등장한다
Deep Dive #4에서는 NUMA를 살펴봤습니다.
Network path 역시 NUMA 관점에서 볼 필요가 있습니다.
NIC
 ↓
NUMA Node
 ↓
CPU Core
 ↓
Cache
 ↓
Memory
 ↓
Application
예를 들어 NIC가 NUMA Node 0에 연결되어 있는데 processing thread가 주로 NUMA Node 1에서 실행된다면 network data가 NUMA interconnect를 건너갈 수 있습니다.
이 과정에서 추가적인 overhead가 발생할 수 있습니다.
따라서:
NIC Locality 역시 CPU Locality의 일부입니다.
전체 topology를 다음과 같이 생각해야 합니다.
NIC
 ↕
CPU
 ↕
Memory
각각을 독립적으로 최적화하는 것보다 전체 data path를 보는 것이 중요합니다.
14. Market Data는 좋은 예제다
고속 시장 데이터를 처리하는 시스템을 생각해보겠습니다.
간단한 구조는 다음과 같습니다.
Exchange
   ↓
NIC
   ↓
Packet Receive
   ↓
Decode
   ↓
Order Book Update
   ↓
Strategy
   ↓
Risk Check
   ↓
Order
   ↓
FEP
각 단계에서 latency가 발생할 수 있습니다.
예를 들어 다음과 같은 경로에서 상당한 시간을 기다리고 있다면:
NIC
 ↓
Interrupt
 ↓
Scheduler
 ↓
Application
End-to-End latency에 영향을 줄 수 있습니다.
따라서 저지연 시스템 설계에서는 불필요한 waiting을 줄이는 것이 중요한 최적화 대상이 됩니다.
15. 하지만 Busy Polling도 공짜가 아니다
Polling이 빠르다고 해서 모든 것을 Polling으로 바꾸는 것은 좋은 설계가 아닙니다.
Polling Thread 하나가 CPU Core 하나를 계속 사용할 수 있습니다.
예를 들어:
Core 0
████████████████████
100% Polling
Network traffic이 전혀 없는 상황에서도 CPU Core가 계속 사용됩니다.
Latency-sensitive workload를 위해 Core 0을 의도적으로 dedicated했다면 이러한 구조가 합리적일 수 있습니다.
하지만 workload가 간헐적이라면 CPU 자원의 낭비가 될 수 있습니다.
결국 중요한 질문은:
Latency 감소가 추가적인 CPU 비용을 감수할 만큼 가치가 있는가?
입니다.
16. Tail Latency가 중요하다
Average latency만 보면 시스템의 실제 동작을 제대로 이해하기 어려울 수 있습니다.
예를 들어:
Average latency: 10 μs
이 숫자 하나만으로는 충분하지 않습니다.
다음과 같은 값도 함께 확인해야 합니다.
P50
P95
P99
P99.9
Median latency가 매우 낮더라도 가끔 긴 지연이 발생할 수 있습니다.
그 원인은 다음과 같을 수 있습니다.
- Interrupt 처리
- Scheduling
- CPU Migration
- Cache Miss
- NUMA Access
- Lock Contention
- Queue Buildup
따라서 저지연 시스템에서는 단순히 평균 latency를 낮추는 것보다:
Latency Predictability
가 중요한 경우가 많습니다.
17. 무엇을 측정해야 하는가?
Network Architecture를 변경하기 전에 먼저 시스템을 측정해야 합니다.
Network
- Packet Rate
- Packet Size
- RX/TX Throughput
- Packet Drop
- Queue Utilization
CPU
- CPU Utilization
- CPU Migration
- Context Switch
- CPU Cycles
- IPC
Cache / Memory
- Cache Miss
- Memory Bandwidth
- NUMA Locality
- Remote Memory Access
Application
- Packet Arrival Timestamp
- Receive Timestamp
- Decode Completion
- Strategy Completion
- Order Submission
- Exchange Response
Latency
- P50
- P95
- P99
- P99.9
- Maximum Latency
목표는 단순히:
"CPU 사용률을 100%로 만드는 것"
이 아닙니다.
목표는:
"Latency가 어디에서 발생하는지를 이해하는 것"
입니다.
18. 실전 아키텍처
Latency-sensitive trading application을 단순화하면 다음과 같은 구조를 생각할 수 있습니다.
             Network
                ↓
               NIC
                ↓
        Interrupt / NAPI
                ↓
         Dedicated CPU
                ↓
        Packet Processing
                ↓
          Shared / Local
             Data
                ↓
            Strategy
                ↓
          Risk Check
                ↓
          Order Manager
                ↓
             FEP
                ↓
           Exchange
중요한 것은 모든 시스템이 반드시 이 구조를 사용해야 한다는 것이 아닙니다.
핵심은 전체 processing path를 이해하는 것입니다.
19. FontesFintech Engineering Approach
FontesFintech에서는 저지연 Network Architecture를 하나의 API 선택 문제로 보지 않습니다.
단순히:
"epoll을 사용할 것인가, Polling을 사용할 것인가?"
라고 질문하는 것에서 끝나지 않습니다.
대신 다음을 확인합니다.
Packet은 어떻게 들어오는가?
        ↓
NIC는 시스템에 어떻게 알리는가?
        ↓
Kernel은 어떻게 처리하는가?
        ↓
Application은 어떻게 데이터를 받는가?
        ↓
어떤 CPU가 처리하는가?
        ↓
Data는 어디에 저장되어 있는가?
        ↓
Application은 어떻게 반응하는가?
        ↓
Order는 얼마나 빠르게 전송되는가?
결국 다음과 같은 전체 경로를 최적화 대상으로 봅니다.
NIC → Interrupt/Polling → Kernel → CPU → Cache → Memory → Application → FEP
그리고 각 단계는 추측이 아니라 측정 후 최적화해야 합니다.
Conclusion
Interrupt와 Polling은 단순히 서로 경쟁하는 기술이 아닙니다.
두 방식은 다음과 같은 요소 사이의 trade-off를 나타냅니다.
Latency
CPU Usage
Throughput
Power
Predictability
Interrupt-driven processing은 시스템이 상당한 시간 동안 idle 상태에 있는 경우 효율적일 수 있습니다.
Polling은 CPU를 지속적으로 활성화함으로써 보다 일정한 processing path를 만들 수 있으며, 극도로 latency에 민감한 workload에서는 유용할 수 있습니다.
현대 Linux networking에서는 NAPI와 같은 방식을 통해 이러한 개념들이 결합되어 사용됩니다.
따라서 저지연 트레이딩 시스템에서 중요한 것은:
"항상 Polling을 사용한다."
도 아니고,
"항상 Interrupt를 사용한다."
도 아닙니다.
중요한 것은:
실제 workload, hardware topology, 그리고 측정된 latency를 기반으로 waiting과 packet-processing 방식을 선택하는 것
입니다.
그리고 다시 한 번 핵심 원칙으로 돌아갑니다.
Measure First. Optimize with Evidence.
Next: Trading Engineering — Deep Dive #7
저지연 트레이딩 시스템에서 NIC Offload와 Kernel Networking이 중요한 이유
다음 글에서는 Network Card 자체를 조금 더 깊게 살펴봅니다.
Hardware Offload, Checksum Processing, Segmentation, Receive/Transmit Queue, RSS 등을 살펴보고, 고성능 트레이딩 시스템에서 NIC가 CPU Core와 어떻게 연결되는지 알아보겠습니다.