Kernel Bypass와 User-Space Networking이 저지연 트레이딩 시스템에서 중요한 이유 | Trading Engineering — Deep Dive #8
Kernel Bypass와 User-Space Networking이 저지연 트레이딩 시스템에서 중요한 이유
Trading Engineering — Deep Dive #8
저지연 트레이딩 시스템에서 네트워크 latency를 줄이려고 하면 자연스럽게 다음과 같은 질문에 도달하게 됩니다.
"애플리케이션이 패킷을 받기 위해 반드시 Kernel을 거쳐야 할까?"
일반적인 Linux networking에서는 다음과 같은 경로를 사용합니다.
NIC
 ↓
Driver
 ↓
Linux Kernel
 ↓
Network Stack
 ↓
Socket
 ↓
Application
이 구조는 매우 안정적이고 범용적입니다.
하지만 극도로 낮은 latency가 필요한 시스템에서는 Kernel을 거치는 과정 자체가 overhead가 될 수 있습니다.
이러한 문제를 해결하기 위한 접근 중 하나가:
Kernel Bypass
그리고 그와 함께 등장하는 개념이:
User-Space Networking
입니다.
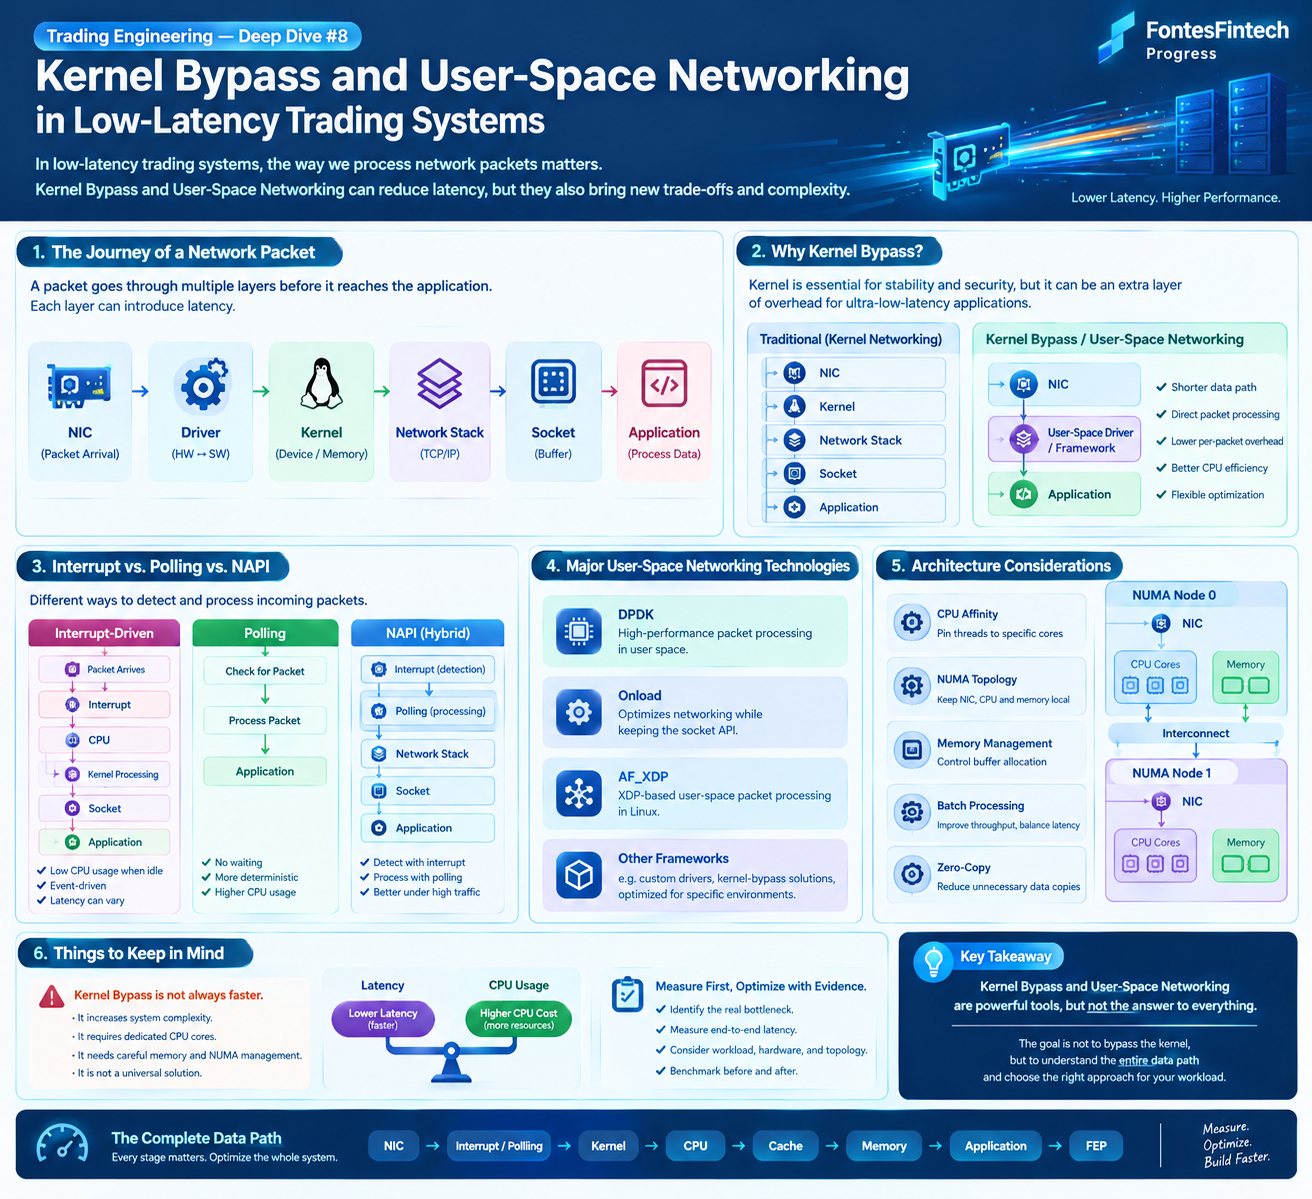
1. 일반적인 Linux Networking
먼저 우리가 익숙한 구조부터 살펴보겠습니다.
애플리케이션이 TCP socket을 사용한다고 가정하면:
Exchange
   ↓
Network
   ↓
NIC
   ↓
NIC Driver
   ↓
Linux Kernel
   ↓
TCP/IP Stack
   ↓
Socket Buffer
   ↓
Application
애플리케이션에서는 일반적으로 다음과 같은 API를 사용합니다.
recv()
read()
epoll_wait()
개발자는 Kernel 내부에서 실제로 어떤 일이 발생하는지 크게 신경 쓰지 않아도 됩니다.
이것이 일반적인 Socket API의 가장 큰 장점입니다.
2. 그렇다면 Kernel은 왜 존재하는가?
여기서 한 가지 오해를 피해야 합니다.
Kernel이 단순히 "느리게 만드는 장애물"인 것은 아닙니다.
Linux Kernel은 다음과 같은 많은 기능을 제공합니다.
- Process Isolation
- Memory Protection
- TCP/IP Protocol Stack
- Socket API
- Routing
- Firewall
- Network Device Management
- Scheduling
- Resource Management
- Driver Management
즉:
Kernel은 성능을 희생해서 만든 불필요한 계층이 아니라, 시스템 전체를 관리하기 위한 핵심 계층입니다.
일반적인 애플리케이션에서는 이러한 기능이 매우 중요합니다.
문제는 특정 분야에서 latency가 지나치게 중요해질 때 발생합니다.
3. Kernel Networking의 비용
일반적인 네트워크 데이터 경로를 단순화하면:
NIC
 ↓
Driver
 ↓
Kernel
 ↓
Network Stack
 ↓
Socket Buffer
 ↓
Application
각 단계에는 처리 과정이 있습니다.
예를 들어:
- Packet descriptor 처리
- Memory management
- Protocol processing
- Socket processing
- Scheduling
- Data movement
등이 발생할 수 있습니다.
이러한 비용은 일반적인 서버에서는 충분히 합리적입니다.
하지만 초저지연 환경에서는 다음과 같은 질문을 할 수 있습니다.
"정말 이 모든 기능이 필요한가?"
4. Kernel Bypass란 무엇인가?
Kernel Bypass는 말 그대로 네트워크 데이터 처리 경로에서 일반적인 Kernel networking path의 상당 부분을 우회하는 방식입니다.
개념적으로 보면:
Traditional

NIC
 ↓
Kernel
 ↓
Socket
 ↓
Application
Kernel Bypass 구조에서는:
Kernel
  │
  │ Control / Setup
  ↓
NIC
  ↓
User Space
  ↓
Application
처럼 데이터 처리의 일부를 User Space에서 직접 수행할 수 있습니다.
핵심은:
Kernel을 완전히 없애는 것이 아니라, latency-sensitive data path에서 Kernel의 개입을 줄이는 것
이라고 이해하는 것이 정확합니다.
5. User-Space Networking
User-Space Networking은 네트워크 패킷 처리의 상당 부분을 User Space에서 수행하는 접근입니다.
전통적인 구조:
NIC
 ↓
Kernel Driver
 ↓
Kernel Network Stack
 ↓
Socket
 ↓
Application
User-Space Networking에서는:
NIC
 ↓
User-Space Driver / Framework
 ↓
Application
와 같이 더 짧은 경로를 만들 수 있습니다.
이 구조를 통해 다음과 같은 최적화를 할 수 있습니다.
- 직접적인 Packet Buffer 관리
- Busy Polling
- Zero-Copy에 가까운 데이터 처리
- Batch Processing
- CPU Core Pinning
- NUMA-aware Memory Allocation
- Lock-free Data Structure
결국 Kernel Bypass는 단순히 Kernel을 하나 제거하는 기술이 아닙니다.
전체 데이터 처리 모델을 바꾸는 접근에 가깝습니다.
6. DPDK
대표적인 User-Space Networking 기술 중 하나가 DPDK(Data Plane Development Kit)입니다.
DPDK는 고성능 packet processing을 위해 User Space에서 네트워크 데이터를 처리할 수 있는 다양한 기능을 제공합니다.
개념적으로 보면:
Traditional

NIC
 ↓
Kernel
 ↓
Socket
 ↓
Application
DPDK와 같은 구조에서는:
NIC
 ↓
DPDK
 ↓
Application
과 같은 데이터 경로를 구성할 수 있습니다.
이때 애플리케이션은 일반적인 recv() 중심의 Socket API 대신 Packet Buffer와 Receive Queue 등을 직접 다루는 구조를 사용할 수 있습니다.
7. Polling이 다시 등장한다
Kernel Bypass를 이야기하면 앞의 Deep Dive #6에서 다룬 Polling이 다시 등장합니다.
User-Space Networking에서는 다음과 같은 구조를 사용할 수 있습니다.
while (running)
{
    packets = poll_rx_queue();

    if (packets > 0)
        process_packets();
}
CPU가 NIC의 Receive Queue를 지속적으로 확인합니다.
따라서:
NIC
 ↓
RX Queue
 ↓
Polling Thread
 ↓
Packet Processing
과 같은 매우 짧은 처리 경로를 만들 수 있습니다.
하지만 이것은 CPU Core를 계속 사용하는 방식입니다.
따라서 Dedicated Core가 중요해집니다.
8. Kernel Bypass + CPU Affinity
앞서 Deep Dive #3에서 CPU Affinity를 살펴봤습니다.
Kernel Bypass 환경에서는 CPU 배치가 더욱 중요해질 수 있습니다.
예를 들어:
              NIC
               │
               ↓
          RX Queue
               │
               ↓
            Core 0
               │
               ↓
        Packet Processing
               │
               ↓
           Strategy
Core 0을 네트워크 packet processing에 dedicated할 수 있습니다.
다른 Core에서는:
Core 1 → Order Book

Core 2 → Strategy

Core 3 → Risk

Core 4 → Order Management
와 같이 역할을 분리할 수도 있습니다.
물론 이것이 모든 시스템에서 최적이라는 의미는 아닙니다.
CPU 자원과 workload를 함께 고려해야 합니다.
9. Kernel Bypass + NUMA
Deep Dive #4에서 다룬 NUMA도 다시 중요해집니다.
예를 들어:
NUMA Node 0

NIC
 │
 ↓
CPU Core 0
 │
 ↓
Local Memory
와 같이 NIC, CPU, Memory를 같은 NUMA Node에 배치하면 데이터 locality를 높일 수 있습니다.
반대로:
NIC
 ↓
NUMA Node 0
 ↓
Interconnect
 ↓
NUMA Node 1
 ↓
CPU
와 같은 구조라면 Remote Memory 또는 Cross-NUMA communication이 발생할 수 있습니다.
따라서 User-Space Networking에서는 다음 세 가지를 함께 봐야 합니다.
NIC + CPU + Memory
10. Zero-Copy는 무엇인가?
Kernel Bypass와 함께 자주 등장하는 개념이 Zero-Copy입니다.
일반적인 데이터 처리에서는 여러 단계에서 데이터가 복사될 수 있습니다.
단순화하면:
NIC Buffer
   ↓ Copy
Kernel Buffer
   ↓ Copy
Application Buffer
각 Copy는 CPU와 Memory Bandwidth를 사용합니다.
가능한 경우:
NIC Buffer
   ↓
Application
처럼 불필요한 데이터 복사를 줄이는 것이 목표가 될 수 있습니다.
이를 흔히 Zero-Copy라는 개념으로 설명합니다.
다만 "Zero-Copy"라는 표현은 시스템마다 의미가 조금씩 다를 수 있습니다.
실제 구현에서는 Buffer Ownership과 Memory Mapping 등을 함께 이해해야 합니다.
11. Packet Buffer의 Ownership
User-Space Networking에서 중요한 개념 중 하나가 Buffer Ownership입니다.
일반적인 Socket API에서는 Kernel이 많은 부분을 관리합니다.
하지만 User Space에서 packet buffer를 직접 관리한다면:
NIC
 ↓
RX Buffer
 ↓
Application
 ↓
Processing
 ↓
TX Buffer
 ↓
NIC
각 buffer가 현재 누구에게 소유되어 있는지를 명확하게 관리해야 합니다.
예를 들어:
NIC owns buffer
       ↓
Application owns buffer
       ↓
NIC owns buffer
와 같은 ownership transition이 필요할 수 있습니다.
이러한 구조는 매우 빠른 processing을 가능하게 할 수 있지만, 동시에 개발 복잡성도 증가시킵니다.
12. Batch Processing
User-Space Networking에서는 여러 packet을 한 번에 처리하는 Batch Processing도 중요한 최적화 방법입니다.
예를 들어:
Packet 1
Packet 2
Packet 3
Packet 4
     ↓
   Batch
     ↓
Processing
Packet 하나마다 함수 호출이나 queue operation을 반복하는 것보다 여러 packet을 묶어 처리하면 per-packet overhead를 줄일 수 있습니다.
특히 높은 packet rate에서는 이러한 방식이 throughput에 도움이 될 수 있습니다.
하지만 역시 trade-off가 있습니다.
Batch size가 너무 커지면:
Latency가 증가할 수 있습니다.
따라서:
Throughput vs. Latency
사이에서 적절한 균형을 찾아야 합니다.
13. Kernel Bypass가 무조건 빠른 것은 아니다
여기서 가장 중요한 부분입니다.
Kernel Bypass를 사용한다고 해서 시스템이 자동으로 빨라지는 것은 아닙니다.
오히려 잘못 설계하면 시스템이 더 복잡해질 수 있습니다.
예를 들어:
Kernel Networking

Application
    ↓
Socket API
    ↓
Kernel
    ↓
NIC
은 상대적으로 단순합니다.
반면 User-Space Networking은:
Application
    ↓
Packet Buffer
    ↓
RX Queue
    ↓
NIC
와 같이 애플리케이션이 훨씬 많은 책임을 가져갈 수 있습니다.
따라서 개발자는 다음을 직접 고려해야 합니다.
- Queue Management
- Buffer Management
- Memory Allocation
- CPU Affinity
- NUMA
- Packet Processing
- Synchronization
- Error Handling
- Packet Drop
- Recovery
- Monitoring
즉:
Latency를 줄이는 대신 시스템 복잡성을 얻을 수 있습니다.
14. Kernel Networking vs. Kernel Bypass
간단히 비교해보겠습니다.
항목Kernel NetworkingKernel Bypass / User Space
| API | Socket | 전용 API / Framework |
| 개발 난이도 | 상대적으로 낮음 | 높음 |
| Kernel 기능 | 풍부함 | Data Path 개입 감소 |
| CPU 효율 | 일반적으로 좋음 | Dedicated Core 사용 가능 |
| Latency | 일반적인 수준 | 매우 낮은 latency를 목표로 설계 가능 |
| Predictability | 환경에 따라 변동 | 전용 환경에서 높일 수 있음 |
| NUMA 관리 | 상대적으로 추상화됨 | 직접 고려하는 경우가 많음 |
| Buffer 관리 | Kernel 중심 | Application/Framework 중심 |
| 유지보수 | 상대적으로 쉬움 | 복잡성 증가 |
| 활용 분야 | 일반 서버 | HFT / Packet Processing / 고성능 네트워크 |
중요한 것은 오른쪽이 무조건 더 좋은 것이 아니라는 점입니다.
15. Kernel Bypass의 대표적인 접근
Kernel Bypass라는 이름 아래에도 여러 가지 접근이 있습니다.
대표적으로 다음과 같은 기술들이 있습니다.
DPDK
User-Space에서 고성능 packet processing을 수행하기 위한 대표적인 framework입니다.
Onload 계열
일반적인 Socket API를 유지하면서 networking path를 최적화하는 접근도 있습니다.
이러한 방식은 애플리케이션의 기존 구조를 크게 바꾸지 않으면서 latency를 줄이는 방향으로 활용될 수 있습니다.
AF_XDP
Linux에서 XDP 기반의 packet processing을 User Space와 연결하는 방법 중 하나입니다.
기타 User-Space Networking
특정 NIC나 trading environment에 최적화된 User-Space networking 기술도 존재합니다.
각 기술은 제공하는 기능과 적용 방식이 다르므로 실제 시스템에서는 NIC, Kernel, Driver, Application Architecture를 함께 검토해야 합니다.
16. Trading System에서는 어떻게 사용할 수 있을까?
고성능 시장 데이터 처리 시스템을 생각해보겠습니다.
일반적인 구조:
Exchange
   ↓
NIC
   ↓
Kernel
   ↓
Socket
   ↓
Market Data Process
   ↓
Order Book
   ↓
Strategy
Kernel Bypass를 사용하는 구조에서는:
Exchange
   ↓
NIC
   ↓
User-Space Packet Processing
   ↓
Market Data
   ↓
Order Book
   ↓
Strategy
처럼 Data Path를 단순화할 수 있습니다.
특히 다음과 같은 workload에서 관심을 가질 수 있습니다.
- 높은 packet rate
- 매우 짧은 latency 요구
- 지속적인 network traffic
- Dedicated CPU Core 사용 가능
- 특정 NIC / Server 환경을 통제할 수 있는 시스템
17. DMA와 User-Space Networking
여기서 DMA도 중요한 역할을 합니다.
NIC는 CPU가 모든 packet data를 직접 복사하도록 만들기보다 DMA를 통해 Memory와 데이터를 주고받을 수 있습니다.
개념적으로:
             NIC
              │
              │ DMA
              ↓
           Memory
              │
              ↓
        User-Space App
이러한 구조를 통해 CPU가 불필요한 데이터 복사 작업을 수행하는 것을 줄일 수 있습니다.
따라서 고성능 네트워크 시스템에서는:
NIC → DMA → Memory → CPU
라는 데이터 경로를 이해하는 것이 중요합니다.
18. FEP와 DMA 시스템에서는?
금융 시스템에서 FEP나 DMA 시스템을 생각해보면 더욱 흥미롭습니다.
예를 들어:
Trading Strategy
      ↓
   Order Manager
      ↓
      FEP
      ↓
      NIC
      ↓
   Exchange
주문이 매우 빠르게 발생하는 환경에서는 단순히 CPU instruction count만 줄이는 것으로 충분하지 않을 수 있습니다.
Network path 자체가 중요합니다.
Application
     ↓
Queue
     ↓
Memory
     ↓
NIC
     ↓
Network
     ↓
Exchange
각 구간의 latency를 측정하고 병목을 찾아야 합니다.
특히 FEP에서는:
- Order serialization
- Queue management
- Memory copy
- NIC transmission
- Kernel networking
- TCP processing
- Retransmission / Recovery
등을 함께 고려해야 합니다.
19. Kernel Bypass가 필요한가?
모든 FEP나 Trading System에 Kernel Bypass가 필요한 것은 아닙니다.
이 부분은 매우 중요합니다.
예를 들어:
Latency Requirement
        ↓
    몇 μs 수준인가?
        ↓
Packet Rate는?
        ↓
CPU Core를 Dedicated할 수 있는가?
        ↓
NIC와 Server를 통제할 수 있는가?
        ↓
Kernel Networking으로 충분한가?
이런 질문을 먼저 해야 합니다.
Kernel Bypass를 도입했는데 실제 병목이:
Strategy Logic
또는:
Lock Contention
또는:
Memory Copy
에 있다면 네트워크만 최적화해도 전체 latency는 크게 줄지 않을 수 있습니다.
20. End-to-End Latency를 봐야 한다
예를 들어:
NIC → Application
구간을 2 μs 줄였다고 생각해봅시다.
하지만 전체 주문 처리 시간이:
Market Data
   ↓
Strategy
   ↓
Risk
   ↓
Order Management
   ↓
FEP
에서 100 μs라면 시스템 전체 성능에 미치는 영향은 제한적일 수 있습니다.
따라서 항상:
End-to-End Latency
를 함께 측정해야 합니다.
앞선 Deep Dive #10에서 다룬 것처럼 P50, P95, P99, P99.9 등의 tail latency도 중요합니다.
21. FontesFintech Engineering Approach
저지연 네트워크에서 중요한 것은 특정 기술의 이름이 아닙니다.
Kernel Networking을 사용할 것인가?
Kernel Bypass를 사용할 것인가?
이것 자체가 목표가 아닙니다.
목표는:
필요한 latency와 throughput을 안정적으로 달성하는 것
입니다.
따라서 FontesFintech에서는 다음과 같은 순서로 접근하는 것을 중요하게 생각합니다.
Measure
   ↓
Find Bottleneck
   ↓
Optimize Application
   ↓
Optimize Memory
   ↓
Optimize CPU
   ↓
Optimize Network
   ↓
Consider Kernel Bypass
   ↓
Benchmark Again
Kernel Bypass는 최적화의 출발점이 아니라 필요할 때 선택할 수 있는 하나의 강력한 도구입니다.
Conclusion
Kernel Bypass와 User-Space Networking은 저지연 시스템에서 매우 강력한 기술입니다.
Kernel Networking이 제공하는 범용성과 안정성을 일부 내려놓는 대신:
- 짧은 Data Path
- 직접적인 Packet Processing
- Dedicated CPU
- NUMA-aware 설계
- Batch Processing
- Buffer 최적화
- 낮은 Data Copy overhead
등을 통해 매우 낮은 latency를 목표로 할 수 있습니다.
하지만 그만큼 시스템 복잡성도 증가합니다.
따라서 중요한 것은:
Kernel을 우회하는 것 자체가 아니라, 왜 우회해야 하는지를 이해하는 것
입니다.
그리고 저지연 시스템에서는 항상 다음 질문으로 돌아가야 합니다.
Where is the latency?
Latency가 어디에서 발생하는지를 측정하고,
Measure → Identify → Optimize → Benchmark
과정을 반복해야 합니다.
결국 좋은 저지연 시스템은 가장 복잡한 기술을 사용하는 시스템이 아니라,
필요한 곳에 필요한 만큼의 최적화를 적용한 시스템
입니다.
Next: Trading Engineering — Deep Dive #9
TCP vs. UDP for Low-Latency Trading Systems
다음 글에서는 금융 시스템에서 매우 자주 등장하는 TCP와 UDP를 본격적으로 비교합니다.
Market Data, Order, Execution Report, Multicast, Reliability, Ordering, Retransmission, Latency 관점에서 두 프로토콜이 어떻게 다른지 살펴보겠습니다.