
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- high frequency trading
- DMA개발
- 주문fep
- 시스템 트레이딩
- Korea dma
- speed trading
- trading engineering
- ultra low latency
- system trading
- hft programming
- 주문 오더북
- 트레이딩 엔지니어링
- 저지연시스템
- 프랍데스크
- HFT system
- 자동매매
- nic offload
- mmlp
- korea inbound
- algo trading
- hft개발
- dma hft
- dma development
- kernel bypass
- futures options
- dma fep
- fep개발
- low latency
- KRX HFT
- hft tuning
- Today
- Total
Fontes Fintech
저지연 트레이딩 네트워크의 내부 구조: UDP 시세와 TCP 주문 흐름 | Trading Engineering — Deep Dive #9 본문
저지연 트레이딩 네트워크의 내부 구조: UDP 시세와 TCP 주문 흐름 | Trading Engineering — Deep Dive #9
폰테스 핀테크 :: 금융거래의 안전한 미래 2026. 10. 2. 21:53저지연 트레이딩 네트워크의 내부 구조: UDP 시세와 TCP 주문 흐름
Trading Engineering — Deep Dive #9
Introduction
저지연 트레이딩 시스템에서 네트워크를 이야기할 때 단순히 TCP와 UDP의 차이를 설명하는 것만으로는 충분하지 않습니다.
실제 거래 시스템에서는 시세 데이터와 주문 데이터가 서로 다른 네트워크 특성을 가진 경로를 따라 이동하기 때문입니다.
한국거래소와 연결되는 일반적인 거래 시스템을 단순화하면 다음과 같은 구조로 볼 수 있습니다.
                     Exchange
                    /        \
                   /          \
          Market Data          Order
             UDP                TCP
              ↓                  ↑
             NIC                NIC
              ↓                  ↑
      Market Data Handler    Order FEP
              ↓                  ↑
          Order Book        Order Manager
              ↓                  ↑
           Strategy ─────→ Risk Check
시세는 UDP Multicast 기반의 고속 데이터 수신 경로를 따라 들어오고,
주문은 TCP 기반의 주문 세션을 통해 거래소로 전달됩니다.
따라서 FEP의 핵심 과제는 프로토콜을 선택하는 것이 아닙니다.
이미 정해진 통신 방식을 얼마나 효율적이고 안정적으로 처리할 것인가
입니다.
이번 Deep Dive에서는 이 네트워크 경로를 패킷 수준에서 살펴보겠습니다.
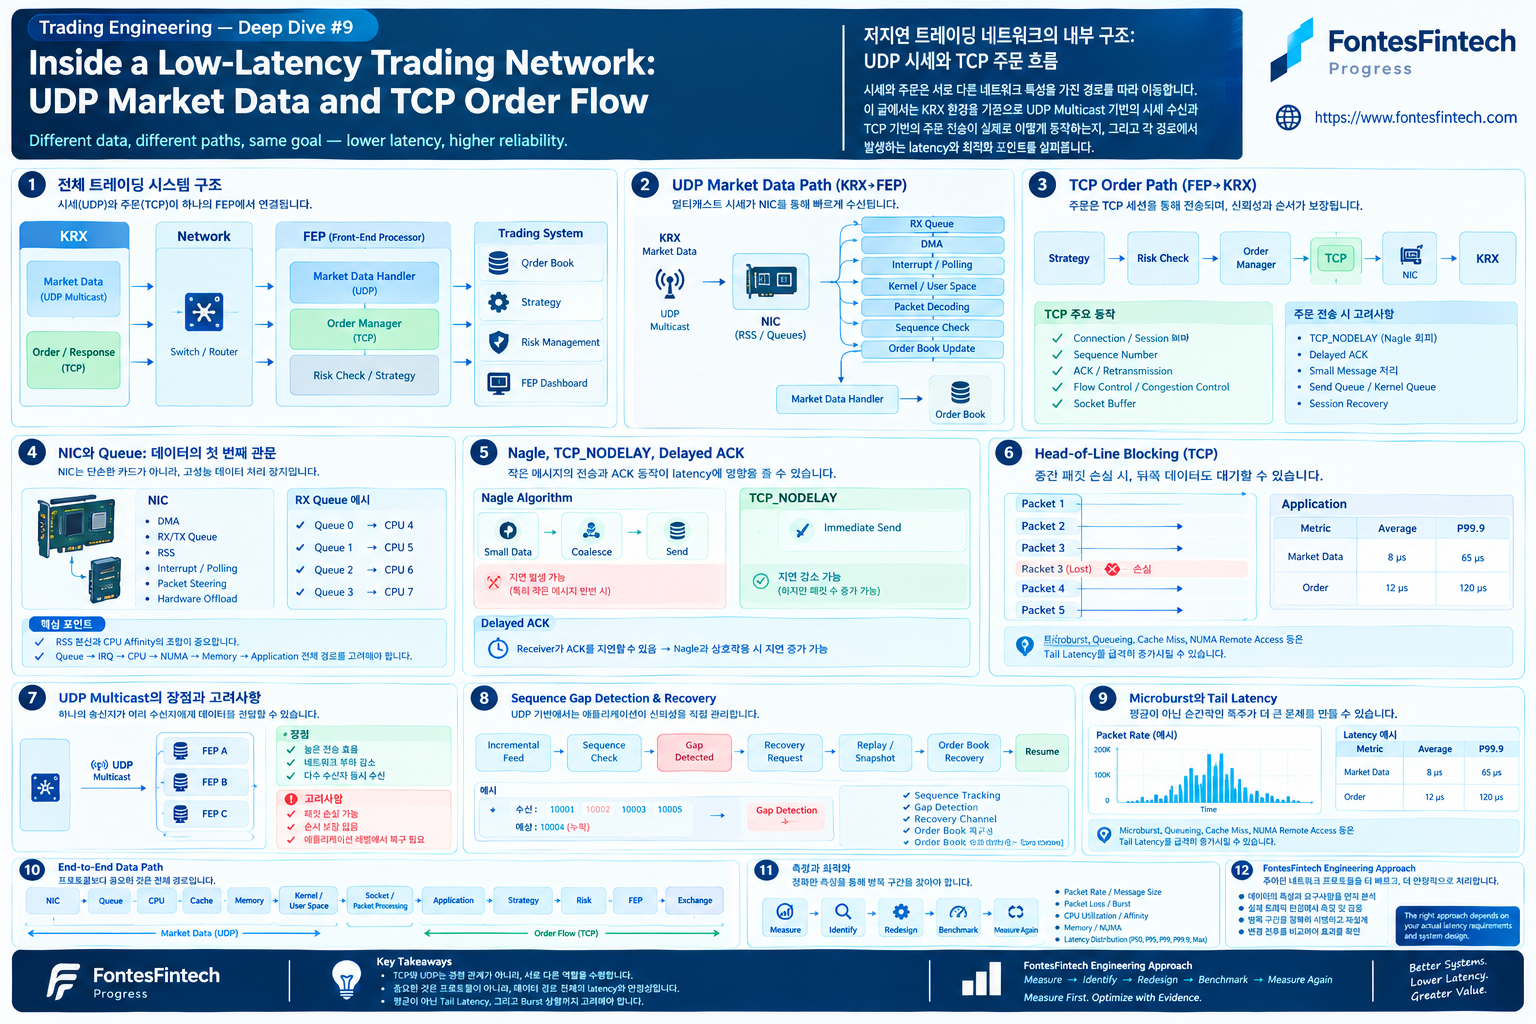
1. 하나의 Trading System, 두 개의 Network Path
트레이딩 시스템에서는 시세와 주문이 완전히 다른 성격을 가지고 있습니다.
Market Data
Exchange
   ↓
UDP Multicast
   ↓
NIC
   ↓
Market Data Handler
   ↓
Order Book
   ↓
Strategy
Order Flow
Strategy
   ↓
Risk Check
   ↓
Order Manager
   ↓
TCP
   ↓
NIC
   ↓
Exchange
두 경로는 서로 연결되어 있지만 요구사항은 다릅니다.
시세 수신에서는:
- 높은 packet rate
- burst traffic
- packet loss detection
- sequence tracking
- multicast
- 빠른 decoding
- 빠른 Order Book update
가 중요합니다.
주문 전송에서는:
- session 상태
- message ordering
- transmission latency
- connection management
- error handling
- response processing
- recovery
등이 중요합니다.
따라서 하나의 FEP 안에서도 네트워크 처리 방식이 서로 달라집니다.
2. UDP Market Data의 실제 경로
시세 데이터가 거래소에서 도착한다고 생각해 보겠습니다.
패킷의 전체 경로는 대략 다음과 같습니다.
Exchange
   ↓
Network
   ↓
NIC
   ↓
RX Queue
   ↓
DMA
   ↓
Interrupt / Polling
   ↓
Kernel / User Space
   ↓
Market Data Handler
   ↓
Decoder
   ↓
Sequence Check
   ↓
Order Book
여기서 중요한 점은 UDP라는 프로토콜 자체가 전체 latency를 결정하지 않는다는 것입니다.
실제로는 다음 단계가 모두 latency에 영향을 줄 수 있습니다.
NIC → Queue → CPU → Memory → Packet Processing → Application
3. NIC는 단순한 네트워크 카드가 아니다
앞선 Deep Dive #7에서 살펴본 것처럼 NIC는 데이터 경로의 첫 번째 중요한 구성요소입니다.
NIC는 단순히 패킷을 받아주는 장치가 아닙니다.
일반적인 고성능 NIC에서는 다음과 같은 기능을 제공합니다.
- DMA
- RX/TX Queue
- RSS
- Interrupt 처리
- Packet Steering
- Hardware Offload
따라서 시세 패킷 하나가 도착하면 다음과 같은 흐름을 거칠 수 있습니다.
Network Packet
      ↓
     NIC
      ↓
   RX Queue
      ↓
     DMA
      ↓
   Memory
CPU가 네트워크 데이터를 직접 한 바이트씩 복사하는 것이 아니라 NIC가 DMA를 이용해 메모리로 데이터를 전달할 수 있습니다.
이후 CPU가 해당 데이터의 처리를 시작합니다.
4. RX Queue와 CPU Affinity
고성능 NIC는 여러 개의 RX Queue를 사용할 수 있습니다.
예를 들어:
NIC
 ├── RX Queue 0 ──→ CPU 4
 ├── RX Queue 1 ──→ CPU 5
 ├── RX Queue 2 ──→ CPU 6
 └── RX Queue 3 ──→ CPU 7
여기서 중요한 것은 단순히 Queue를 많이 사용하는 것이 아닙니다.
어떤 Queue가 어떤 CPU에서 처리되는가가 중요합니다.
특히 저지연 시스템에서는 다음 관계를 함께 확인해야 합니다.
NIC Queue
    ↓
IRQ / Polling
    ↓
CPU Core
    ↓
NUMA Node
    ↓
Memory
    ↓
Application Thread
이 중 하나라도 잘못 배치되면 예상하지 못한 latency가 발생할 수 있습니다.
5. RSS는 만능이 아니다
RSS(Receive Side Scaling)는 네트워크 flow를 여러 RX Queue로 분산시키는 기능입니다.
일반적인 구조는 다음과 같습니다.
                 NIC
                  │
             RSS Hash
          ┌───────┼───────┐
          ↓       ↓       ↓
       Queue 0 Queue 1 Queue 2
          ↓       ↓       ↓
       CPU 4    CPU 5    CPU 6
일반적인 서버에서는 이것이 매우 유용합니다.
하지만 저지연 시스템에서는 분산 자체보다 데이터가 어디에서 처리되는가가 중요할 수 있습니다.
예를 들어 특정 Market Data Feed를 처리하는 핵심 thread가 CPU 4에 고정되어 있는데 패킷이 여러 CPU로 분산된다면 오히려 데이터 locality가 나빠질 수 있습니다.
따라서 RSS는 단독으로 튜닝하는 것이 아니라:
RSS → RX Queue → IRQ Affinity → CPU Affinity → NUMA
전체를 함께 봐야 합니다.
6. Interrupt와 Polling
패킷이 도착하면 CPU가 처리해야 합니다.
여기에는 크게 두 가지 방식이 사용될 수 있습니다.
Interrupt-driven
Packet
  ↓
NIC
  ↓
Interrupt
  ↓
CPU
  ↓
Packet Processing
패킷이 도착했을 때 CPU에 이벤트를 알려주는 방식입니다.
Polling
CPU
 ↓
Check Queue
 ↓
Packet?
 ├─ No → Check Again
 └─ Yes → Process
Polling은 CPU를 계속 사용합니다.
하지만 전용 CPU Core를 확보할 수 있는 저지연 시스템에서는 이것이 반드시 단점은 아닙니다.
중요한 목표가 CPU utilization 최소화가 아니라 latency와 latency predictability일 수 있기 때문입니다.
7. Microburst
시세 데이터에서는 평균 packet rate만 보고 시스템을 설계하면 위험할 수 있습니다.
예를 들어 평균적으로는:
10,000 packets/sec정도라고 하더라도 특정 순간에 매우 많은 데이터가 몰릴 수 있습니다.
Packet Rate

             ████████████
             ████████████
             ████████████
_______________________________
                 Time
이러한 짧은 burst를 Microburst라고 볼 수 있습니다.
이때 중요한 것은 평균 처리량이 아니라 순간적인 처리 능력입니다.
다음 요소가 영향을 받습니다.
- NIC RX Ring
- RX Queue
- Kernel Queue
- Socket Buffer
- Application Queue
- CPU Processing Rate
따라서:
Average Throughput ≠ Burst Handling Capability
입니다.
8. Sequence Number와 Gap Detection
UDP 기반 Market Data에서 중요한 것은 패킷을 받았다는 사실만으로 정상적인 데이터를 받았다고 판단할 수 없다는 것입니다.
시장 데이터 메시지에 Sequence Number가 있다고 가정해 보겠습니다.
10001
10002
10003
10004
10005
정상입니다.
하지만 다음과 같이 들어온다면:
10001
10002
10003
10005
Application은 즉시 이상을 감지할 수 있습니다.
Expected : 10004
Received : 10005

       ↓

   GAP DETECTED
이것이 Gap Detection입니다.
UDP에서는 이러한 검증이 특히 중요합니다.
9. Gap Recovery
Gap을 발견했다고 해서 Market Data Handler를 멈출 수는 없습니다.
시스템에는 Recovery 구조가 필요합니다.
개념적으로는 다음과 같습니다.
Incremental Feed
       ↓
Sequence Check
       ↓
Gap Detected
       ↓
Recovery Request
       ↓
Replay / Snapshot
       ↓
Order Book Recovery
       ↓
Resume Incremental Feed
여기서 중요한 것은 Recovery 자체의 속도만이 아닙니다.
Recovery 중에도 정상적인 시세 처리를 어떻게 유지할 것인가가 중요한 설계 문제가 됩니다.
따라서 Market Data 시스템은 단순한 UDP Receiver가 아니라 State Reconstruction System에 가깝습니다.
10. Order Book은 Network의 다음 단계다
시세 패킷을 빠르게 받는 것만으로는 충분하지 않습니다.
Market Data Handler가 패킷을 해석하고 Order Book을 업데이트해야 합니다.
UDP Packet
    ↓
Decode
    ↓
Sequence Check
    ↓
Message Classification
    ↓
Order Book Update
    ↓
Strategy
여기서도 latency가 발생합니다.
예를 들어:
- Memory Copy
- Parsing
- Branching
- Cache Miss
- Lock
- Shared Data
- False Sharing
등이 문제가 될 수 있습니다.
따라서 네트워크 최적화와 CPU/Memory 최적화는 분리해서 볼 수 없습니다.
11. TCP Order Path
이제 반대편의 주문 경로를 살펴보겠습니다.
Strategy에서 주문이 발생하면 일반적으로 다음과 같은 경로를 생각할 수 있습니다.
Strategy
   ↓
Risk Check
   ↓
Order Manager
   ↓
TCP
   ↓
Socket
   ↓
Kernel Network Stack
   ↓
NIC TX Queue
   ↓
Network
   ↓
Exchange
시세 수신과 달리 주문은 송신 latency가 매우 중요합니다.
특히 전략이 주문을 생성한 순간부터 실제 NIC가 패킷을 전송하기까지의 경로가 중요합니다.
12. TCP Send Path
Application이 다음과 같이 데이터를 전송한다고 생각해 봅시다.
send(sock, buffer, length, 0);하지만 send() 호출이 곧바로
"지금 NIC에서 패킷이 나갔다"
라는 의미는 아닙니다.
개념적으로는:
Application
     ↓
send()
     ↓
Socket Buffer
     ↓
TCP Processing
     ↓
IP
     ↓
NIC Driver
     ↓
TX Queue
     ↓
NIC
     ↓
Network
라는 여러 단계가 존재합니다.
따라서 주문 latency를 정확히 측정하려면 Application timestamp 하나만으로는 부족합니다.
13. TCP_NODELAY와 Small Order Message
주문 메시지는 상대적으로 작은 데이터인 경우가 많습니다.
이때 TCP의 packetization behavior가 latency에 영향을 줄 수 있습니다.
Nagle Algorithm은 작은 TCP 데이터를 모아서 전송하는 방향으로 동작할 수 있습니다.
저지연 주문 경로에서는 이를 피하기 위해 TCP_NODELAY를 고려할 수 있습니다.
int flag = 1;

setsockopt(
    sock,
    IPPROTO_TCP,
    TCP_NODELAY,
    &flag,
    sizeof(flag)
);
하지만 여기에서도 중요한 원칙이 있습니다.
TCP_NODELAY를 켠다고 전체 주문 latency가 자동으로 최적화되는 것은 아닙니다.
오히려 작은 packet이 지나치게 많이 발생하면:
- Packet Rate 증가
- CPU overhead 증가
- NIC processing 증가
- Interrupt/Polling workload 증가
등의 다른 비용이 생길 수 있습니다.
따라서 실제 환경에서 측정해야 합니다.
14. TCP Session과 Connection State
주문 FEP에서는 단순히 데이터를 보내는 것 외에도 TCP Connection 자체가 중요한 상태입니다.
TCP Session
 ├── Connection
 ├── Send State
 ├── Receive State
 ├── Sequence
 ├── ACK
 └── Recovery
특히 연결 장애가 발생하면 단순히 Socket을 다시 만드는 것으로 끝나지 않을 수 있습니다.
FEP는 다음과 같은 상태를 관리해야 합니다.
- Connection Status
- Session Status
- Outstanding Message
- Reconnect
- Recovery
- Duplicate Prevention
- Order State
즉, TCP는 단순한 Socket API가 아니라 주문 시스템의 상태 관리와 연결된 하나의 Session Layer가 됩니다.
15. UDP와 TCP의 공통적인 문제
프로토콜은 다르지만 두 경로에는 공통적으로 발생하는 문제가 있습니다.
NIC
 ↓
Queue
 ↓
CPU
 ↓
Cache
 ↓
Memory
 ↓
Application
예를 들어:
Cache Miss
데이터가 CPU Cache에 없다면 Memory Access가 발생할 수 있습니다.
NUMA Remote Access
Thread와 Memory가 다른 NUMA Node에 위치할 수 있습니다.
Memory Copy
불필요한 데이터 복사가 발생할 수 있습니다.
Lock Contention
여러 Thread가 동일한 데이터를 동시에 접근할 수 있습니다.
Thread Migration
Network Processing Thread가 다른 Core로 이동할 수 있습니다.
즉,
TCP와 UDP의 차이보다 Network-to-Application Path 전체가 더 중요할 수 있습니다.
16. FEP에서 중요한 Data Path
저지연 FEP를 하나의 데이터 경로로 보면 다음과 같이 표현할 수 있습니다.
             MARKET DATA
                  │
                  ▼
           UDP Multicast
                  │
                  ▼
                 NIC
                  │
             RX Queue
                  │
                  ▼
          Market Data Handler
                  │
                  ▼
              Order Book
                  │
                  ▼
               Strategy
                  │
                  ▼
              Risk Check
                  │
                  ▼
            Order Manager
                  │
                  ▼
                 TCP
                  │
                  ▼
                 NIC
                  │
                  ▼
               EXCHANGE
이 구조에서 latency-sensitive path는 크게 두 방향입니다.
Market Data → Strategy
그리고
Strategy → Exchange
입니다.
첫 번째는 시세를 얼마나 빨리 받아 전략에 전달하는가,
두 번째는 주문을 얼마나 빨리 거래소로 전달하는가의 문제입니다.
17. End-to-End Latency
따라서 FEP의 성능을 평가할 때 단순히
UDP latency = X μs
TCP latency = Y μs
처럼 보는 것은 충분하지 않습니다.
실제로는 다음과 같은 측정이 필요합니다.
Market Data
Exchange Timestamp
       ↓
NIC Receive
       ↓
Market Data Handler
       ↓
Decode
       ↓
Order Book
       ↓
Strategy
Order
Strategy Decision
       ↓
Risk Check
       ↓
Order Manager
       ↓
Socket Send
       ↓
NIC TX
       ↓
Exchange
각 구간에 timestamp를 넣으면 어디에서 latency가 발생하는지 확인할 수 있습니다.
18. Tail Latency
저지연 시스템에서 평균 latency만 보는 것도 위험합니다.
예를 들어:
MetricResult
| P50 | 8 μs |
| P95 | 11 μs |
| P99 | 18 μs |
| P99.9 | 65 μs |
| Max | 420 μs |
평균 latency가 매우 낮더라도 특정 상황에서 latency spike가 발생할 수 있습니다.
따라서 FEP에서는:
P50 → P95 → P99 → P99.9 → Max
를 함께 보는 것이 중요합니다.
특히 Microburst, CPU Scheduling, NUMA Remote Access, Cache Miss, Queueing 등의 상황에서 Tail Latency가 급격히 증가할 수 있습니다.
19. Kernel Networking과 Kernel Bypass
앞의 Deep Dive #8에서 살펴본 Kernel Bypass도 이 구조에서 연결됩니다.
일반적인 경로:
NIC
 ↓
Driver
 ↓
Kernel
 ↓
Network Stack
 ↓
Socket
 ↓
Application
User-Space Networking을 사용하는 경우:
NIC
 ↓
Queue
 ↓
User-Space Packet Processing
 ↓
Application
처럼 데이터 경로를 더 직접적으로 구성할 수 있습니다.
하지만 여기에서도 중요한 것은:
Kernel Bypass를 사용하는 것 자체가 목표가 되어서는 안 된다는 것
입니다.
실제로 latency가 어디에서 발생하는지를 측정한 후 필요한 부분만 최적화해야 합니다.
20. 하나의 FEP에서 모든 최적화가 연결된다
지금까지의 Deep Dive를 하나의 FEP에 연결해 보면 상당히 재미있는 구조가 나옵니다.
CPU Cache
    ↓
False Sharing
    ↓
CPU Affinity
    ↓
NUMA
    ↓
Polling
    ↓
Interrupt / NAPI
    ↓
NIC / RSS / Queue
    ↓
Kernel Networking
    ↓
Kernel Bypass
    ↓
UDP Market Data
    ↓
Order Book
    ↓
Strategy
    ↓
Risk Check
    ↓
TCP Order Flow
    ↓
FEP
    ↓
Exchange
각각의 기술은 서로 독립적인 것이 아닙니다.
하나의 End-to-End Trading Path를 구성하는 서로 다른 계층입니다.
21. FontesFintech Engineering Approach
저지연 금융 시스템에서는 특정 기술을 사용하는 것 자체보다 전체 데이터 경로를 이해하는 것이 중요합니다.
우리는 다음과 같은 질문에서 시작할 수 있습니다.
Where is the latency actually being spent?
그리고 다음과 같은 순서로 접근합니다.
Measure
어디에서 시간이 소비되는지 측정합니다.
↓
Identify
Latency의 원인을 구분합니다.
↓
Redesign
필요한 부분의 구조를 변경합니다.
↓
Benchmark
변경 전후를 동일한 조건에서 비교합니다.
↓
Measure Again
실제 latency distribution이 개선되었는지 확인합니다.
이 과정에서 CPU, Memory, NIC, Kernel, Network Protocol, Application을 따로 보지 않고 하나의 End-to-End System으로 바라봅니다.
Conclusion
실제 트레이딩 시스템에서 UDP와 TCP는 서로 경쟁하는 선택지가 아닙니다.
시세와 주문이라는 서로 다른 데이터 흐름을 처리하기 위해 서로 다른 역할을 수행합니다.
Market Data
UDP Multicast → NIC → RX Queue → Market Data Handler → Order Book → Strategy
Order Flow
Strategy → Risk Check → Order Manager → TCP → NIC → Exchange
따라서 저지연 FEP의 핵심은 TCP와 UDP 중 무엇을 선택하는 것이 아닙니다.
진짜 중요한 것은:
주어진 네트워크 프로토콜을 얼마나 짧고 예측 가능한 데이터 경로로 처리할 것인가
입니다.
이를 위해서는
NIC → Queue → CPU → Cache → Memory → Kernel/User Space → Application → FEP → Exchange
전체 경로를 함께 바라봐야 합니다.
그리고 마지막에는 항상 측정으로 돌아옵니다.
Measure the Path. Understand the Bottleneck. Optimize with Evidence.


